Quelles plantes poussent ici ? Challenge Kaggle GeoLifeCLEF
Deviner quelles espèces végétales poussent en un point d'Europe à partir d'images Sentinel-2, de séries Landsat et climatiques et de variables environnementales : c'était un challenge Kaggle de deep learning en 2026, sur les données GeoLifeCLEF 2025. Modèle multimodal construit en équipe de cinq, 1re des 4 équipes.
- Classement final, 4 équipes
- 1re
- F1 Kaggle, ensemble final de 10 modèles
- 0,23389
- F1 du tableau final (référence à 0,21495)
- 0,20227
- Espèces à prédire, sur 88 987 relevés
- 5 016
Contexte et problème
Un point GPS en Europe, une liste d’espèces végétales à deviner. Pour chaque relevé, le modèle reçoit un patch satellite Sentinel-2 de 640 m de côté, vingt ans de séries Landsat, des séries climatiques, le sol, l’altitude et l’empreinte humaine, et doit rendre l’ensemble des espèces présentes. C’est de la classification multi-label extrême : 5 016 espèces possibles, 14 présentes par relevé en médiane.
Le challenge, organisé sur Kaggle en 2026, reprenait les données de la compétition GeoLifeCLEF 2025 dans une compétition privée. Ce type de modèle sert à cartographier finement la biodiversité et à guider l’identification d’espèces sur le terrain. Nous étions cinq : Yasmina Saoud et Adrian Guilhem à la modélisation, Raihan Meguenni, Malala Ravalisaona et Guilhem Darde sur l’interprétation des données (serveur MCP, statistiques, explications par LLM).
Données
- Relevés Presence-Absence : 88 987 relevés d’entraînement et 5 016 espèces (log d’entraînement du dépôt), environ 14 800 relevés de test.
- Observations Presence-Only : environ 5 millions d’observations opportunistes sur toute l’Europe, biaisées vers les zones très prospectées, utilisées pour le pré-entraînement.
- Prédicteurs : image Sentinel-2 64 x 64 pixels à 4 canaux (RGB et proche infrarouge), séries Landsat (21 années x 24 variables), séries bioclimatiques (12 pas x 76 variables), 64 variables environnementales et 57 variables auxiliaires (coordonnées, année, pays et région encodés).
- Le décalage géographique : 67,4 % des relevés de test sont à plus de 10 km des données d’entraînement. Le Danemark fait 55 % de l’entraînement pour environ 5 % du test ; l’Ukraine, la Bulgarie et le Royaume-Uni font 20 %, 22 % et 6 % du test pour environ 0 % de l’entraînement.
- Licence : jeu de données GeoPlant sous CC BY 4.0 (Picek et al., NeurIPS 2024). Rien n’est redistribué dans le dépôt ; les données se téléchargent depuis Kaggle et le dépôt Seafile des organisateurs.
Approche
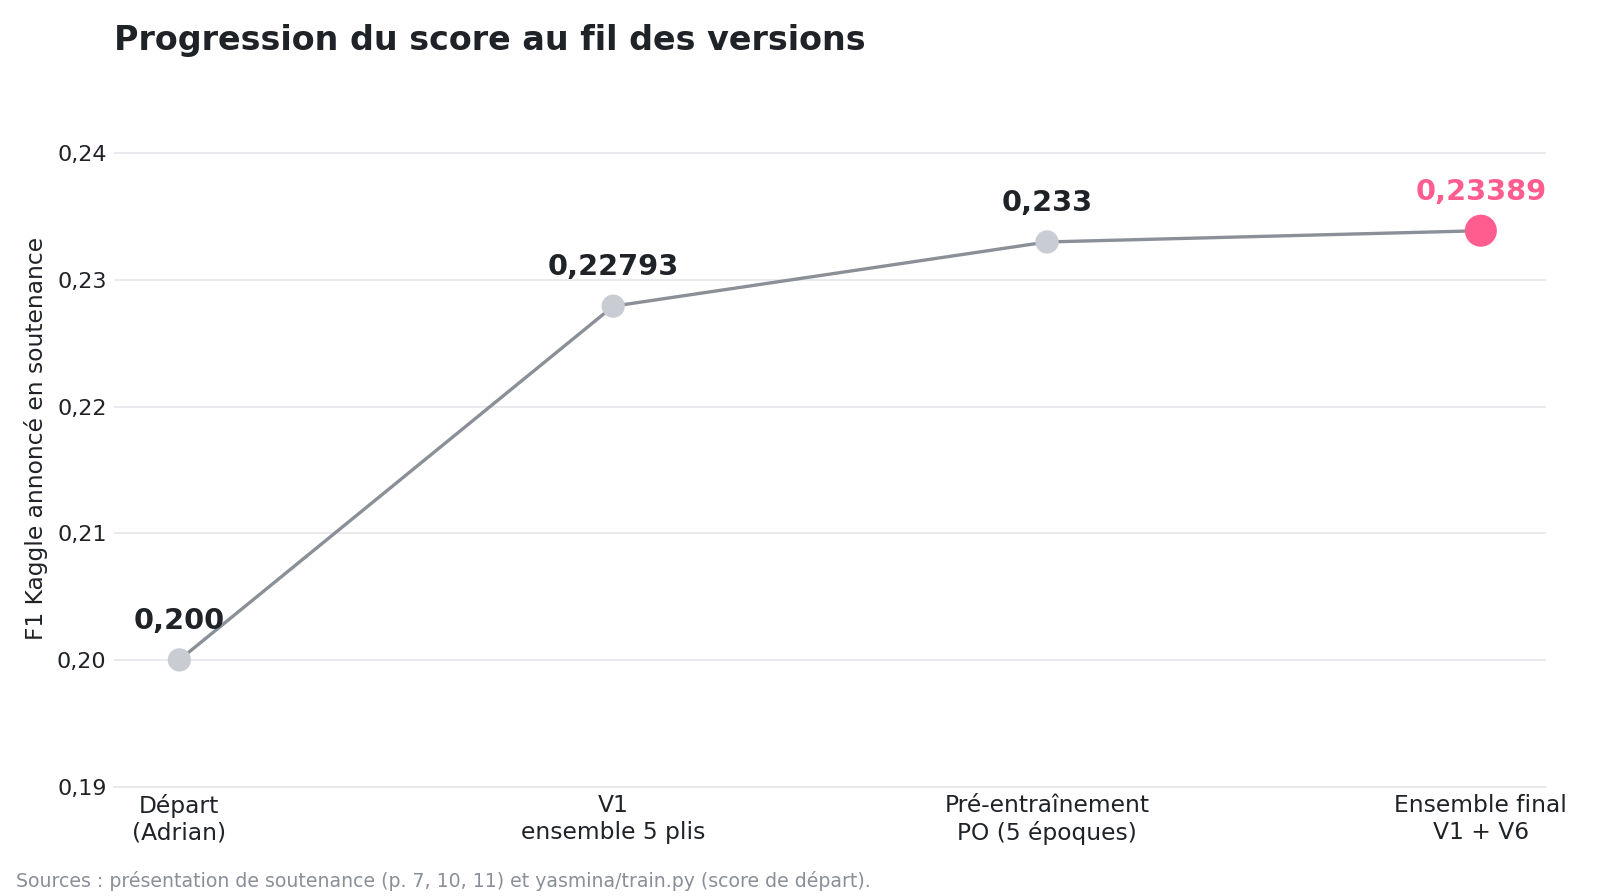
Le modèle de départ d’Adrian fusionne cinq branches : un encodeur d’image, deux Transformers pour les séries Landsat et climatiques, deux MLP pour les variables tabulaires, chacune réduite à 128 dimensions, puis une tête de fusion qui produit un logit par espèce. Il obtenait 0,200 sur le classement public.
Pour la V1, j’ai travaillé l’entraînement avant de toucher à l’architecture. Sans rien changer au modèle, cette
version (dossier yasmina/ du dépôt) entraîne cinq modèles sur cinq plis de validation spatiale et moyenne leurs
logits, avec warmup de 3 époques puis décroissance cosinus, précision mixte, clipping de gradient et 50 époques.
Résultat : 0,22793. La présentation note que ce gain vient surtout de l’ensemble, et qu’un plafond est atteint
sans changer l’architecture.
Vient ensuite la branche image. Nous avons comparé six encodeurs Sentinel-2 : un petit CNN, EfficientNet-B3, ResNet-50, ConvNeXt-Tiny, ConvNeXt-Tiny avec attention pooling et Swin-Tiny. Nous avons gardé EfficientNet-B3, pré-entraîné sur ImageNet et adapté à 4 canaux (le canal proche infrarouge reprend les poids du rouge).
Troisième pièce, le pré-entraînement Presence-Only. Les encodeurs tabulaires sont d’abord entraînés sur les 5 millions d’observations Presence-Only (tâche à une seule étiquette), puis le modèle complet est affiné sur les relevés Presence-Absence : 0,233.
Le nombre d’espèces rendues par relevé n’est pas fixe : il vaut la somme des probabilités multipliée par un facteur calibré sur la validation, borné entre 1 et 50.
L’ensemble final moyenne les logits de 10 modèles, 5 de la V1 et 5 de la V6. D’après la présentation, la V1 est forte sur les régions bien couvertes et la V6 sur les régions hors distribution ; leurs biais se compensent : 0,23389.
Choix techniques
| Choix | Plutôt que | Pourquoi |
|---|---|---|
| EfficientNet-B3 à 4 canaux (environ 12 M paramètres) | ResNet-50, ConvNeXt-Tiny, Swin-Tiny (23 à 31 M) | Le meilleur compromis à l’essai : ResNet-50 plus lourd sans gain net, ConvNeXt moins stable selon les plis, Swin pas meilleur |
| Validation spatiale en 5 plis (blocs de 1 degré) | Découpage aléatoire | Le test est géographiquement éloigné de l’entraînement : un découpage aléatoire surestimerait le score |
| Moyenne des logits de 10 modèles (V1 + V6) | Un seul modèle | Réduit la variance ; V1 et V6 ont des erreurs complémentaires (dans et hors distribution) |
| Pré-entraînement Presence-Only court : 5 époques | 15 époques | 0,233 contre 0,175 : au-delà, les encodeurs se sur-spécialisent sur la tâche Presence-Only |
| 7 variables auxiliaires pour le pré-entraînement | 57 variables | 0,233 contre 0,226 : plus de variables n’aidait pas le transfert |
| Nombre d’espèces calibré par relevé | Top-k fixe | La richesse varie fortement d’un site à l’autre ; le facteur est optimisé pour le F1 sur la validation |
Résultats et métriques
| Étape | F1 Kaggle |
|---|---|
| Modèle de départ | 0,200 (public) |
| V1 : ensemble 5 plis | 0,22793 |
| Pré-entraînement Presence-Only, 5 époques | 0,233 |
| Ensemble final V1 + V6, 10 modèles | 0,23389 |
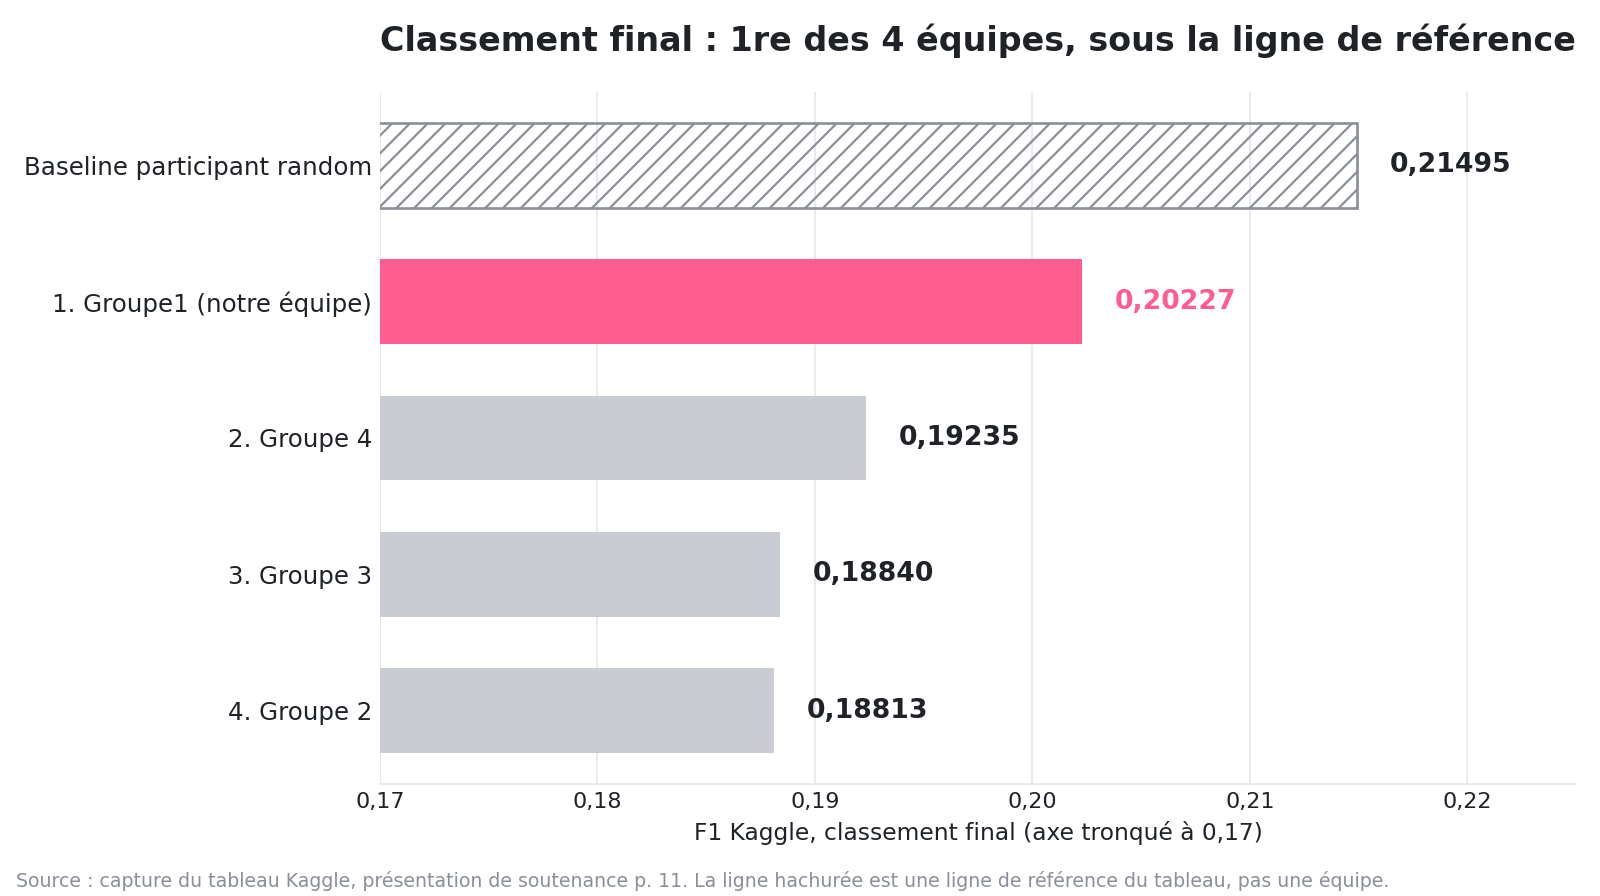
Au classement final, notre équipe (« Groupe1 ») termine 1re des 4 équipes avec 0,20227, devant 0,19235, 0,18840 et 0,18813. Une ligne « Baseline participant random » figure au-dessus de toutes les équipes, à 0,21495.
La métrique est un F1 entre l’ensemble d’espèces prédit et l’ensemble observé. La présentation parle de F1 micro ; le code de validation calcule un F1 par relevé moyenné sur les relevés, la métrique décrite par l’article GeoPlant. En validation spatiale interne, les modèles atteignaient environ 0,35 : l’écart avec Kaggle mesure le coût du décalage géographique.
Le dépôt republié rassemble le code des cinq membres, avec les chemins de serveur remplacés par des variables d’environnement, un environnement uv et un test de fumée qui instancie les architectures et vérifie une sortie de 5 016 logits sur tenseurs aléatoires, sans données ni GPU (6 tests réussis sur un portable).
Impact métier
Compétition privée sur Kaggle, menée à cinq : rien n’a été livré à un utilisateur. Le destinataire naturel d’un tel modèle serait une équipe de recherche en biodiversité ou un bureau d’études environnement préparant un inventaire floristique, pour décider où envoyer les botanistes en premier.
- Mesuré : le modèle couvre 5 016 espèces apprises sur 88 987 relevés de terrain, et rend pour chaque
point une liste dont la longueur est calibrée relevé par relevé, entre 1 et 50 espèces
(
results/scores_kaggle.json). - Mesuré : le score F1 passe de 0,200 pour le modèle de départ à 0,23389 pour l’assemblage final
(
results/scores_kaggle.json). À ce niveau, la liste prédite sert à orienter une sortie de terrain ; elle ne remplace pas un inventaire et ne dispense d’aucune vérification humaine. - Mesuré : le score tombe de 0,3459 en validation spatiale
(
results/validation/adrian_asym_globalnorm_clean_fold0.json) à 0,20227 sur le classement final (results/scores_kaggle.json), alors que 67,4 % des points de test sont à plus de 10 km des zones d’entraînement (section Données). La fiabilité baisse là où personne n’a encore prospecté, c’est-à-dire là où on voudrait justement s’en servir. C’est la limite qui compterait pour un commanditaire.
Limites et pistes d’amélioration
- Nous n’avons pas battu la ligne de référence. La première place est un rang entre équipes : sur le tableau final, 0,20227 reste sous 0,21495. La présentation ne dit pas comment cette référence a été construite.
- Deux scores pour une même équipe. L’ensemble est annoncé à 0,23389, le tableau final affiche 0,20227. Hypothèse, non vérifiable avec les fichiers : le premier serait un score du classement public (une partie du test), le second celui du classement privé révélé à la fin ; la soumission retenue pourrait aussi ne pas être l’ensemble.
- Généralisation géographique : environ 0,35 en validation contre 0,20 à 0,23 sur Kaggle. Pistes : pondérer les régions sous-représentées, valider en laissant des pays entiers de côté, exploiter davantage les Presence-Only des pays absents de l’entraînement.
- Espèces rares : 3 203 espèces ont moins de 10 occurrences dans le split d’entraînement d’un des pipelines.
- Reproductibilité partielle : poids et soumissions n’ont pas été conservés, aucun script ne combine V1 et V6, et le script de pré-entraînement est resté réglé sur la variante à 15 époques. Les chiffres viennent de la présentation finale, pas d’une nouvelle exécution.