Assistant RE2020 : RAG hybride et agent outillé
Une recherche hybride, lexicale et vectorielle, sur 694 passages de textes RE2020 officiels, chacun citable avec son document et son article. Elle place la bonne source dans les dix premiers résultats pour 87,5 % des questions de test ; la rédaction automatique, elle, n'est pas encore exploitable.
En cours de réalisation
- Rappel@10, recherche hybride
- 0,875
- MRR, recherche hybride
- 0,541
- nDCG@10, recherche hybride
- 0,614
- Passages officiels indexés
- 694
Contexte et problème
Les règles de la RE2020, la réglementation environnementale des bâtiments neufs, sont réparties entre le code de la construction et de l’habitation, l’arrêté du 4 août 2021 et ses onze annexes, et un guide ministériel de 93 pages. Une question aussi banale que « quel seuil carbone pour une maison dont le permis est déposé en 2025 ? » suppose de retrouver le bon tableau, le bon usage de bâtiment et la bonne tranche d’années. Un assistant généraliste répond de mémoire, sans source, et sans distinguer les versions successives des textes. Sur un sujet réglementaire, sa réponse est inexploitable.
J’ai donc pris le problème par la recherche : l’assistant ne répond qu’à partir de passages qu’il a réellement retrouvés dans les textes officiels, il cite le document et l’article dont il se sert, et il refuse quand les sources ne couvrent pas la question.
Données
Douze documents officiels téléchargés par script le 22 septembre 2026, avec leur empreinte SHA-256 dans un manifeste : l’arrêté du 4 août 2021 en version consolidée au 19 mars 2026 (articles 1 à 52), huit de ses annexes, l’annexe de l’article R. 172-4 du code de la construction et de l’habitation dans sa version applicable au 1er juillet 2026, et le guide RE 2020 du ministère (Cerema, janvier 2024).
Les fichiers du portail RT-RE bâtiment sont sous Licence Ouverte Etalab 2.0. Légifrance refuse les téléchargements automatisés, alors j’ai repris la version consolidée de l’arrêté dans la base AIDA de l’Ineris, en faisant citer à chaque passage l’URL Légifrance de référence. Après extraction et découpage par section, j’obtiens 694 passages et 726 000 caractères. Chaque passage porte son document, sa section, sa page et son URL, sans quoi il ne serait pas citable.
Approche
Deux moteurs de recherche indépendants sur le même corpus. Le lexical est un BM25 avec normalisation française maison : accents retirés, élisions coupées, mots vides français, racinisation Snowball, mais identifiants réglementaires conservés intacts, sans quoi Bbio_max, Q4Pa-surf ou 0,60 seraient détruits par la racinisation. Le sémantique est un index vectoriel construit avec le modèle multilingue e5-small exporté en ONNX quantifié en entiers 8 bits, stocké dans un Qdrant en mode local sur disque. Je fusionne les deux classements par Reciprocal Rank Fusion.
Au-dessus, un agent porté par un modèle ouvert exécuté en local avec Ollama appelle deux outils.
rechercher_reglementation renvoie des passages numérotés avec leur citation. calculer évalue une
expression arithmétique en analysant son arbre syntaxique au lieu d’appeler eval. La consigne du modèle
impose une citation par affirmation et un refus explicite quand les passages ne suffisent pas.
Pour l’évaluation, j’ai écrit 37 questions à partir des textes, dont cinq hors périmètre auxquelles la bonne réponse est un refus, et quatre questions de calcul. Chaque question déclare la phrase exacte attendue dans les textes au lieu d’un identifiant de passage, ce qui garde le jeu valable si je change le découpage ; un test vérifie que chaque phrase attendue existe bien dans le corpus.
Choix techniques
| Choix | Plutôt que | Pourquoi |
|---|---|---|
| Recherche hybride BM25 et vectoriel | Vectoriel seul | Les questions reprennent les identifiants réglementaires, et le lexical seul bat le vectoriel seul sur presque toutes les mesures |
| e5-small ONNX quantifié int8 | Modèle d’embeddings plus grand | Avec 8 Go de RAM partagés, il tient sous 500 Mo et construit l’index sur CPU en 10 minutes |
| Qdrant en mode local sur disque | Serveur vectoriel ou FAISS | L’index pèse 2,8 Mo, aucun service à lancer, et un clone vierge le reconstruit |
| Calculatrice par arbre syntaxique | eval sur l’expression du modèle |
Un outil exposé à un LLM ne doit jamais exécuter de code arbitraire |
| Phrases attendues plutôt qu’identifiants | Identifiants de passages figés | Le jeu d’évaluation survit à un changement de découpage et reste vérifiable dans les textes |
| Modèle ouvert local servi par Ollama | API payante d’un fournisseur | Aucun coût, aucune donnée envoyée à un tiers ; en échange, la latence et la qualité sont celles mesurées ici |
Résultats et métriques
Les mesures portent sur les 32 questions qui attendent une réponse, et viennent de
results/retrieval_metrics.json.
| Moteur | Rappel@1 | Rappel@3 | Rappel@5 | Rappel@10 | MRR | nDCG@10 | Latence médiane |
|---|---|---|---|---|---|---|---|
| BM25 seul | 0,266 | 0,594 | 0,750 | 0,828 | 0,472 | 0,552 | 2,9 ms |
| Vectoriel seul (e5-small) | 0,281 | 0,422 | 0,453 | 0,625 | 0,376 | 0,430 | 23,5 ms |
| Hybride (RRF) | 0,359 | 0,578 | 0,750 | 0,875 | 0,541 | 0,614 | 26,5 ms |
Les colonnes de qualité sont déterministes et se reproduisent à l’identique. La latence dépend de la charge du poste : sur quatre exécutions successives du 23/09/2026, la médiane va de 2,9 à 4,2 ms pour BM25, de 23,1 à 26,3 ms pour le vectoriel et de 26,5 à 30,4 ms pour l’hybride. Le tableau reprend l’exécution enregistrée dans le fichier plutôt qu’une moyenne des quatre.
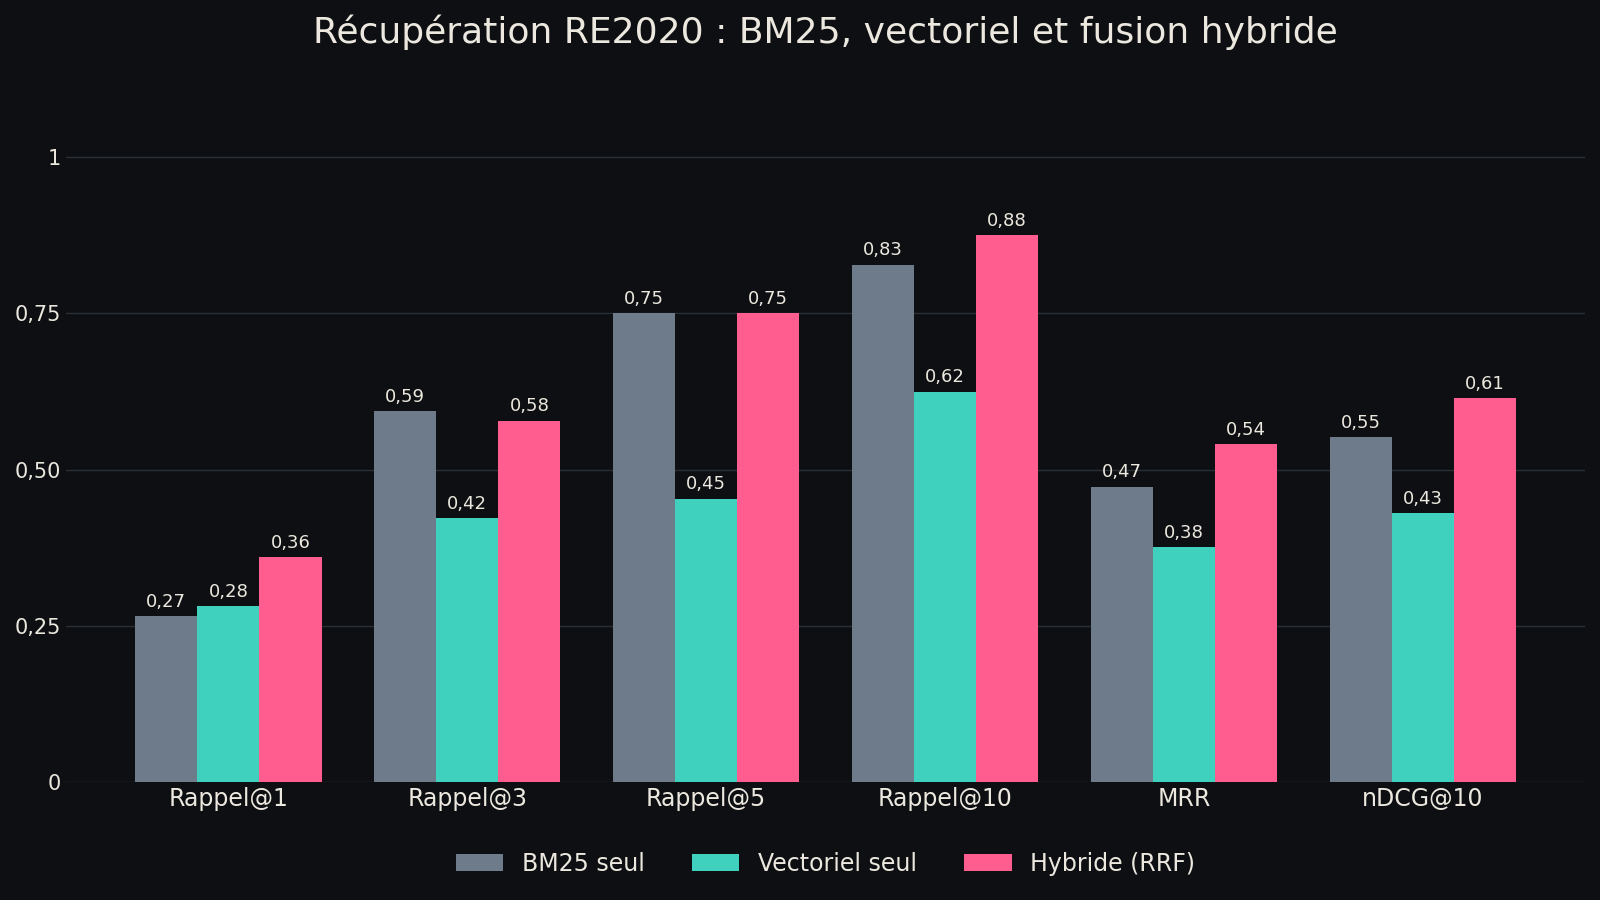
La fusion hybride gagne sur le premier résultat, le rappel à 10, le MRR et le nDCG. Elle perd 1,6 point de rappel@3 face à BM25 seul, et le vectoriel ne sauve qu’une seule question sur les 32. Sur un corpus aussi technique, le lexical fait donc l’essentiel du travail ; l’hybride ajoute quelques points là où ça compte, sans plus.
La génération tourne en local, avec un modèle ouvert servi par Ollama au lieu d’une API payante. Ma première mesure, sur les 37 questions du jeu d’évaluation avec Qwen2.5 1,5 milliard de paramètres quantifié en Q4_K_M, est franchement mauvaise, et je la publie telle quelle : le modèle ne répond qu’à 3,1 % des questions du périmètre, refuse toutes les autres, rend 32 réponses sur 37 sans aucune citation, et met 62,5 secondes par question en médiane. Ces chiffres de génération viennent d’une exécution locale que je n’ai pas encore publiée dans le dépôt, contrairement à ceux de la récupération. Il refuse bien 100 % des questions hors périmètre, ce qui ne coûte pas cher quand on refuse presque tout.
Le montage est peut-être autant en cause que le modèle : une boucle d’appel d’outils demande beaucoup à 1,5 milliard de paramètres. J’analyse donc une seconde configuration, sans appel d’outils, qui place directement les meilleurs passages dans l’invite. Tant que la comparaison des deux n’est pas terminée, je ne donne aucun chiffre de génération comme définitif, et la fiche reste en cours.
Impact métier
Je pense à un bureau d’études thermiques, ou à un chargé d’affaires en maîtrise d’œuvre, qui doit retrouver le seuil réglementaire applicable à un projet et surtout pouvoir le citer. Ce que je livre aujourd’hui, c’est une recherche documentaire mesurée. L’assistant ne rédige rien d’exploitable pour l’instant.
- Mesuré : 694 passages issus de 12 documents officiels, chacun portant son document, sa section, sa
page et son URL, donc recopiable dans une note avec sa référence (
results/retrieval_metrics.json). - Mesuré : la bonne source figure dans les dix premiers résultats pour 87,5 % des 32 questions du jeu
d’évaluation, en 26,5 ms de calcul en médiane (
results/retrieval_metrics.json). La recherche rend la main immédiatement ; la lecture et la décision restent humaines. - Estimé, au conditionnel : en supposant qu’un chargé d’affaires mette plusieurs minutes à retrouver le bon tableau dans un arrêté de 52 articles, ses huit annexes et un guide de 93 pages, ce que la structure du corpus rend plausible, l’outil ramènerait cette recherche à la lecture de dix passages déjà référencés.
- Non démontré : la rédaction automatique de la réponse n’est pas exploitable en l’état, avec 3,1 % des questions du périmètre traitées. Je ne revendique aucun gain de rédaction tant que la comparaison des deux configurations n’est pas terminée.
Limites et pistes d’amélioration
Le rappel@1 de 0,359 reste faible : deux tiers des questions ne trouvent pas leur source en premier résultat. L’agent s’en sort parce qu’il reçoit cinq passages et peut relancer une recherche, ce qui reste un contournement. Les seuils vivent dans des tableaux à plusieurs entrées que l’extraction PDF aplatit en suites de nombres, donc les deux pistes qui me semblent utiles sont un reclassement par cross-encoder et un découpage plus fin de ces tableaux. Trois questions ne sont trouvées par aucun moteur dans les dix premiers résultats.
Le corpus est partiel, et c’est un choix : la méthode de calcul Th-BCE et les règles Th-Bat, plusieurs centaines de pages, ne sont pas indexées, et le décret lui-même manque faute d’accès automatisé à Légifrance. Le guide de janvier 2024 peut aussi contredire le texte consolidé de 2026 sur les points modifiés depuis. Quant à la génération, ma première mesure montre surtout ce qu’on peut attendre d’un modèle de 1,5 milliard de paramètres sur un poste de 8 Go. Les deux questions que je n’ai pas tranchées : modèle ouvert local ou modèle hébergé, et agent outillé ou chaîne directe.