Vélos en libre-service : pipeline streaming du flux GBFS
Le flux Vélomagg de Montpellier est remplacé toutes les 60 secondes et n'en garde aucune trace. Je le capte en continu, je l'écris dans PostgreSQL sans jamais compter deux fois le même instantané, et toute la pile démarre avec un seul docker compose up.
- Relevés insérés en base
- 16 848
- Latence p95 de bout en bout
- 41,0 s
- Tests de qualité dbt passés
- 35 / 35
- Doublons écartés
- 52
Contexte et problème
Le flux GBFS de Montpellier Méditerranée Métropole publie toutes les 60 secondes l’état des 52 stations Vélomagg : vélos disponibles, bornes libres, station en service ou non. Il ne conserve rien. Chaque instantané écrase le précédent, qui disparaît. Résultat, l’exploitant qui cherche où les vélos manquent en fin de journée, comme l’usager qui se demande si sa station est fiable le matin, n’a aucun historique à consulter.
J’ai donc écrit la couche qui manque : capter le flux en continu, garantir qu’un même instantané ne soit jamais compté deux fois, et ranger le tout dans un modèle analytique testé. Le tableau de bord affiche l’état du pipeline en même temps que celui du réseau, parce qu’un pipeline arrêté ressemble beaucoup à un réseau vide. Contrainte que je me suis donnée : tout démarre en une seule commande, sur un poste ordinaire.
Données
Source : gbfs.theta.fifteen.eu/gbfs/2.2/montpellier/en, GBFS 2.2, système velomagg_montpellier,
opérateur TaM, licence ODbL 1.0 annoncée dans le flux, jeu référencé sur transport.data.gouv.fr.
52 stations, 659 bornes déclarées, ttl de 60 secondes.
J’interroge deux fichiers : station_information.json (nom, coordonnées, capacité) et
station_status.json (vélos et bornes disponibles). Un détail du flux a changé la conception : les
52 stations partagent la même valeur de last_reported, égale au last_updated de l’enveloppe.
L’opérateur publie un instantané global, il ne date pas chaque station séparément. Ma clé de déduplication
est donc le couple (station, instant de publication), et je ne peux pas évaluer la fraîcheur station par
station.
J’ai collecté pendant 5,14 heures le 22 septembre 2026, de 13:28 à 18:37 UTC : 309 interrogations, 308 instantanés distincts, 16 016 relevés de station. L’écart médian entre deux instantanés est de 60 secondes, le maximum de 64, et aucun intervalle ne dépasse 90 secondes, donc je n’ai manqué aucune mise à jour. Au moment où je lis le flux, il a déjà 35,9 secondes d’âge en médiane, 60 au maximum.
Approche
Le producteur interroge les deux fichiers à la fréquence annoncée par le flux et publie un message par
station dans Redpanda, avec station_id en clé pour que les relevés d’une même station restent ordonnés.
Les descriptions de stations ne repartent que lorsqu’elles changent (comparaison d’empreinte), sur un topic
compacté.
Le consommateur lit par lots, valide chaque message contre un schéma explicite, écarte les doublons à
l’intérieur du lot, écrit en une transaction PostgreSQL, puis valide les décalages Kafka. L’ordre de ces
opérations fait tout le travail : la livraison Kafka est « au moins une fois », et c’est la contrainte
d’unicité (station_id, last_reported) avec ON CONFLICT DO NOTHING qui rend l’écriture idempotente.
Chaque lot enregistre ses compteurs (reçus, valides, insérés, doublons écartés, invalides) dans une table
de suivi, et les messages refusés partent dans raw.rejected_messages avec leur motif.
Le schéma vient de migrations SQL versionnées, appliquées par un petit lanceur maison qui enregistre version et somme de contrôle : une migration déjà appliquée puis modifiée fait échouer le démarrage. Au-dessus, dbt construit les vues de staging, la dimension station, une table de faits incrémentale, les agrégats horaires par station et pour le réseau, et le classement des stations les plus souvent vides. Les tests de qualité tournent avec les modèles, toutes les 15 minutes : unicité, non-nullité, bornes, relation vers la dimension, fraîcheur de la source, et vélos disponibles jamais supérieurs à la capacité. Grafana est provisionné par fichiers, source de données et tableau de bord sont dans le dépôt.
Choix techniques
| Choix | Plutôt que | Pourquoi |
|---|---|---|
| Redpanda en mode dev | Kafka avec KRaft ou ZooKeeper | Même protocole client, un seul binaire, et il démarre avec --smp 1 --memory 512M. Sur un poste de 8 Go, le compose doit aussi loger PostgreSQL, dbt et Grafana |
| Clé unique en base plus validation tardive des décalages | Recherche d’un « exactement une fois » applicatif | La base écarte le doublon, le compteur de lot le prouve, et une panne du consommateur ne provoque ni perte ni double écriture |
| dbt | Vues SQL écrites à la main | Le graphe de dépendances est explicite, les tests sont versionnés avec les modèles, et la table de faits incrémentale ne retraite que les nouvelles lignes |
Test générique maison accepted_range |
Paquet dbt_utils |
Trois lignes de Jinja m’évitent un dbt deps au démarrage du conteneur, donc un accès réseau et un cache de plus |
clock_timestamp() pour l’heure d’insertion |
now() |
now() renvoie l’heure de début de transaction : toutes les lignes d’un lot auraient la même heure et la latence mesurée serait fausse |
| Migrations SQL versionnées avec somme de contrôle | CREATE TABLE IF NOT EXISTS au démarrage |
L’historique du schéma se lit dans le dépôt, et une migration modifiée après coup est détectée au lieu de passer inaperçue |
Résultats et métriques
Mon poste n’a pas de moteur Docker utilisable : Docker Desktop plante au démarrage sur un socket périmé
(removing stale socket: ... userAnalyticsOtlpHttp.sock: The file cannot be accessed by the system), trois
tentatives, même erreur. J’ai donc fait tourner la pile en intégration continue GitHub, qui fournit
Docker : run 35797505264,
tâche pipeline, conclusion success. Ce run monte le compose, rejoue l’archive réelle de 5,14 heures,
ingère le flux en direct pendant 8 minutes, lance dbt build et pytest, puis exporte les chiffres par
requêtes SQL. Le débit vient donc d’un rejeu d’archive ; seules les 8 minutes en direct mesurent une
latence.
| Mesure | Valeur | Source |
|---|---|---|
| Messages reçus par le consommateur | 17 264 | results/synthese.json |
| Relevés insérés en base | 16 848 | results/synthese.json |
| Doublons écartés par la clé unique | 52 | results/synthese.json |
| Messages invalides (schéma) | 0 | results/synthese.json |
| Latence de bout en bout en direct (p50 / p95) | 38,44 s / 40,99 s | results/latence.json |
| Latence du pipeline seul en direct (p50 / p95) | 2,879 s / 5,431 s | results/latence.json |
| Âge du flux à la lecture (p50) | 34,54 s | results/latence.json |
| Tests de qualité dbt | 35 réussis sur 35 (le total PASS=42 de dbt ajoute les 7 modèles construits) |
results/dbt_build.txt |
| Tests unitaires Python | 22 passés | results/pytest.txt |
| Relevés sans aucun vélo | 13,59 % | results/vides_pleines_global.json |
| Relevés sans aucune borne libre | 0,00 % | results/vides_pleines_global.json |
| Taux de remplissage moyen | 25,31 % | results/vides_pleines_global.json |
| Relevés avec plus de vélos que la capacité | 0 | results/vides_pleines_global.json |
Sur 38,4 secondes de bout en bout en médiane, 34,5 viennent de l’âge du flux avant même que je le lise. Tout ce que le pipeline ajoute tient sous 6 secondes au 95e centile, Redpanda, validation, déduplication et écriture PostgreSQL comprises. Quant aux 52 doublons écartés, ils s’expliquent exactement : une interrogation redondante de l’archive, donc 52 stations rejetées par la clé unique.
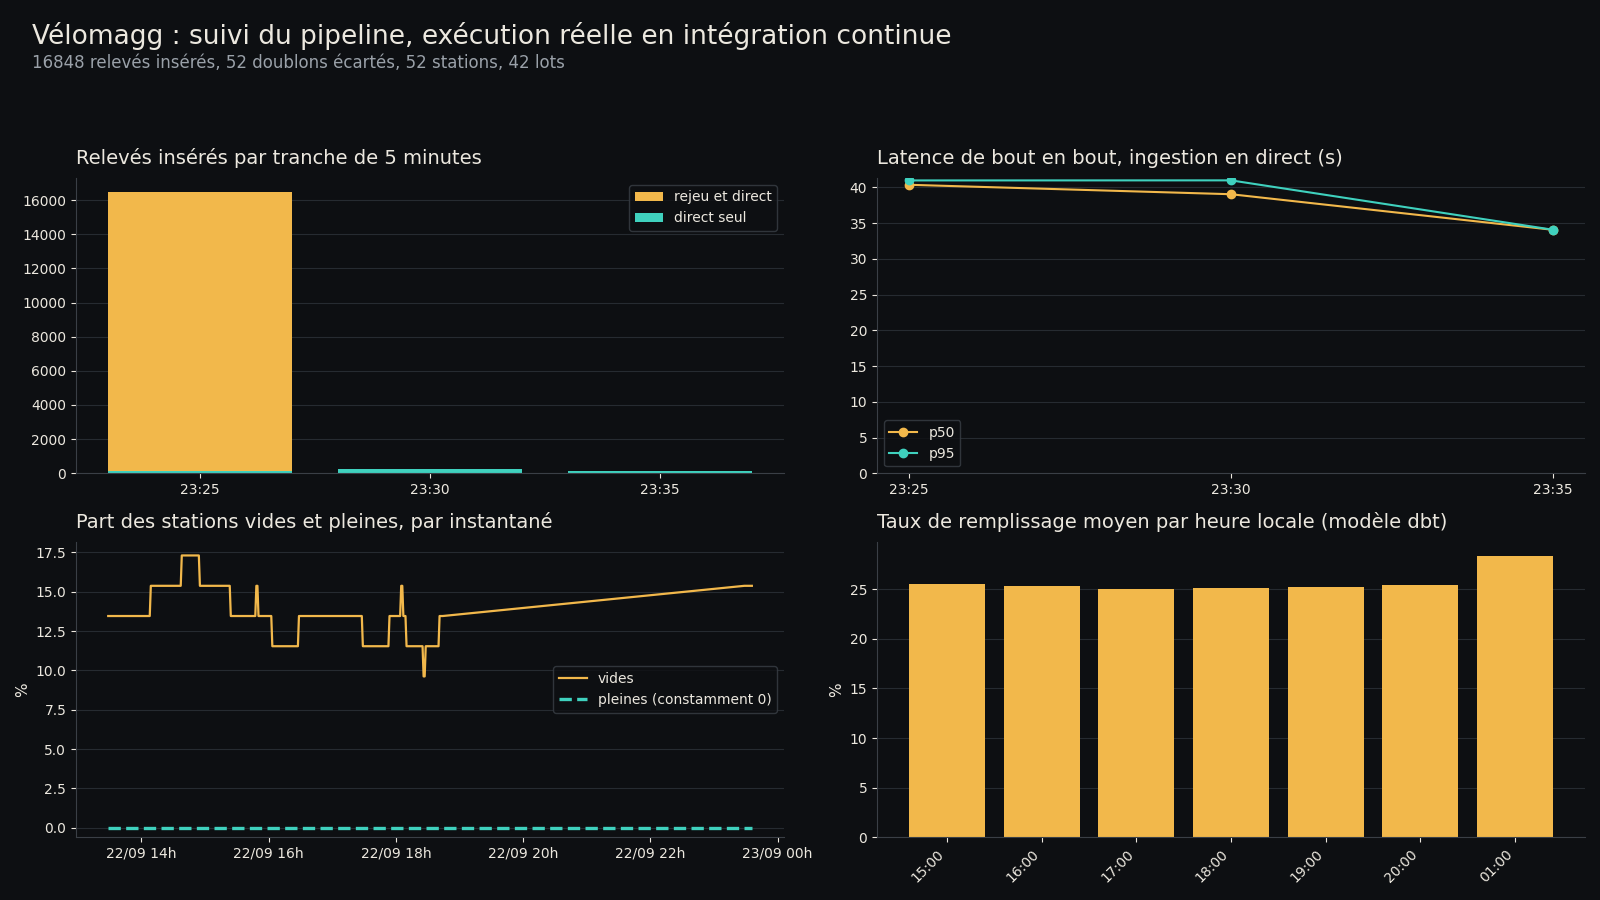
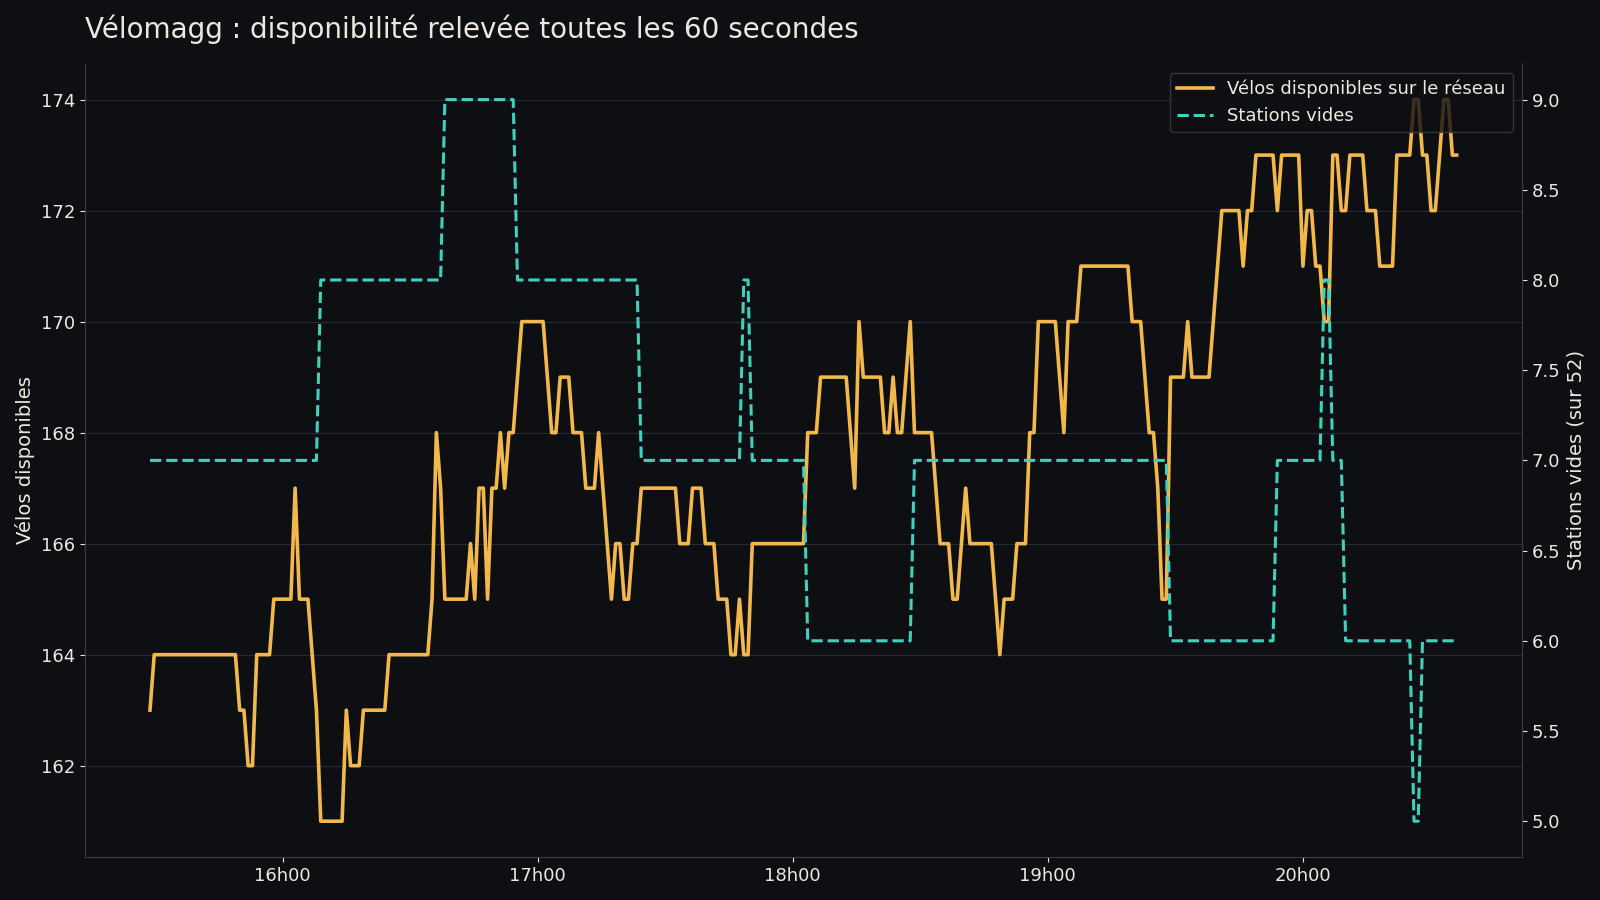
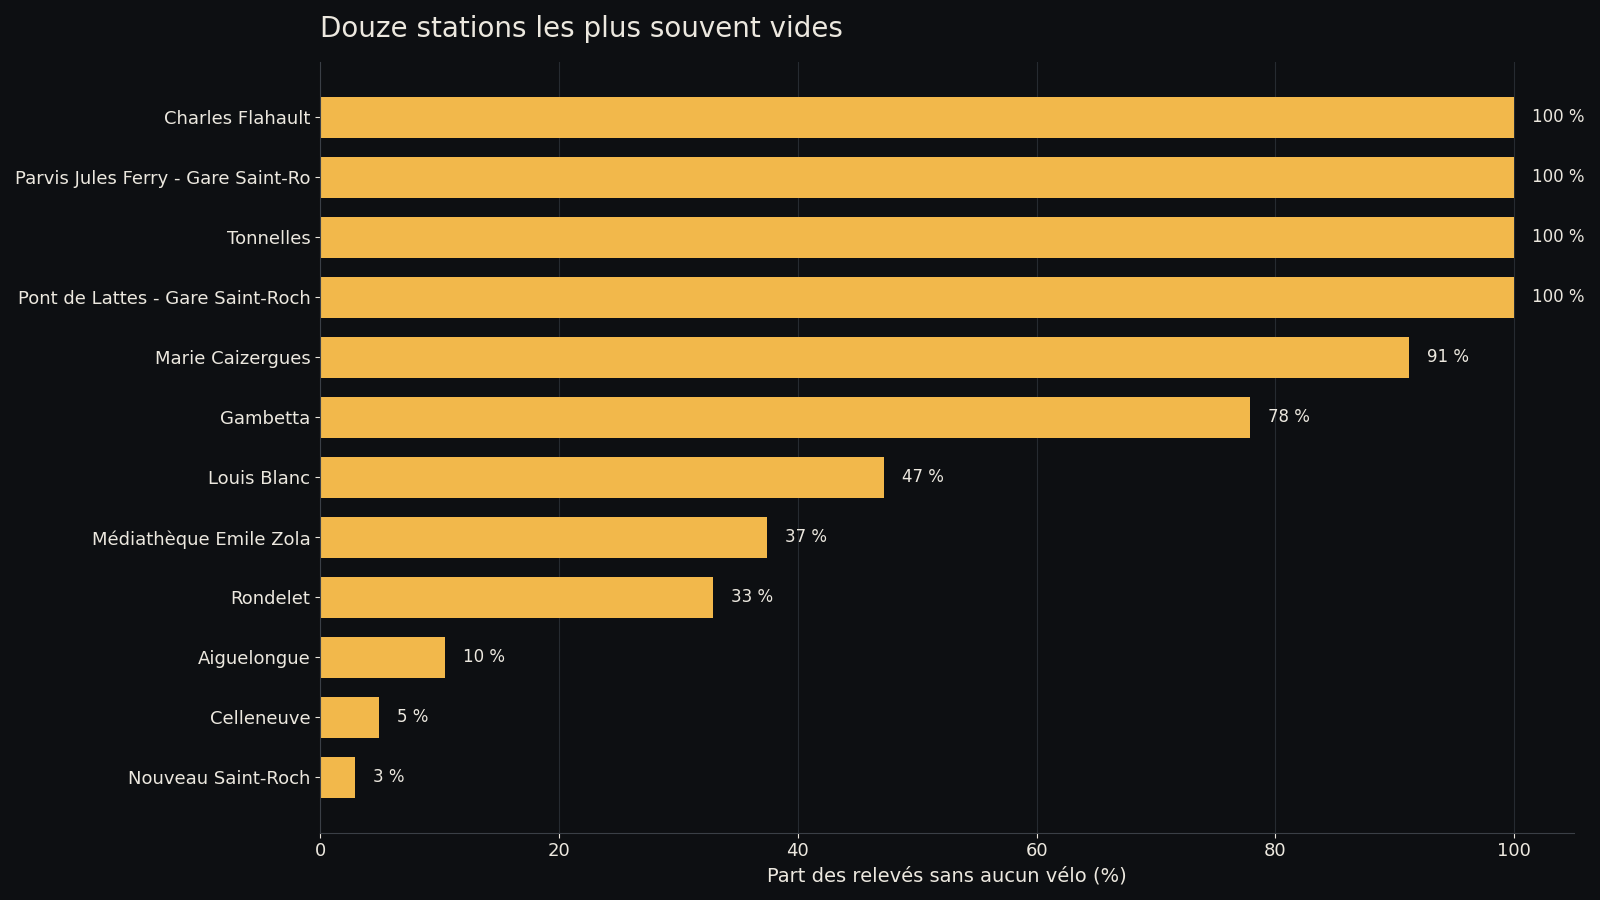
Côté métier, sur cette fin d’après-midi de semaine, le réseau ne dépasse jamais quelques dizaines de vélos disponibles pour 659 bornes. 13,59 % des relevés correspondent à une station sans aucun vélo, et aucune station n’a jamais été pleine. Ce qui manque sur cette tranche horaire, ce sont les vélos, et le manque se concentre : quatre stations sur 52 sont restées vides sur la totalité de la période observée.
Impact métier
Pour l’exploitant d’un réseau de vélos en libre-service, ou pour le service mobilité d’une collectivité, cet historique sert deux décisions concrètes : où envoyer le camion de rééquilibrage, et quelles stations redimensionner.
- Mesuré : 13,59 % des relevés correspondent à une station sans aucun vélo, 0,00 % à une station sans
borne libre, et 4 stations sur 52 sont restées vides sur toute la période observée
(
results/vides_pleines_global.json,results/stations_vides_pleines.csv). Le manque porte donc sur les vélos, et il se concentre sur quelques points du réseau. - Mesuré : entre la publication du flux et la donnée disponible en base, le pipeline ajoute moins de
6 secondes au 95e centile (
results/latence.json). Une alerte « station vide » partirait donc dans la minute qui suit la publication. - Mesuré : les 35 contrôles de qualité tournent à chaque construction, toutes les 15 minutes, et celui
de fraîcheur avertit après 5 minutes sans nouvelle donnée (
results/dbt_build.txt,dbt/models/staging/sources.yml), donc je repère un flux figé dans le quart d’heure. - Portée honnête : ces parts valent pour 5,14 heures d’un mardi après-midi. Elles montrent ce que le pipeline permet de mesurer. Le matin et le week-end restent à observer.
Limites et pistes d’amélioration
Je n’ai pas de copie d’écran du tableau de bord Grafana : le runner d’intégration continue n’a pas de
navigateur, et mon poste n’a pas de moteur Docker, donc personne n’a affiché l’interface. Le service
démarre (il figure dans results/docker_compose_ps.txt), son tableau de bord est provisionné et commité,
et j’ai refait ses quatre panneaux en image à partir des mêmes requêtes SQL. Cela prouve que les données
existent. Cela ne prouve pas que Grafana les affiche correctement.
Autre limite, le débit observé vient d’un rejeu d’archive, et l’ingestion en direct n’a duré que 8 minutes, soit 468 relevés seulement pour mesurer la latence. La durée de collecte pose le même genre de problème : cinq heures d’un mardi après-midi ne disent rien des pointes du matin, du week-end ni de la météo. Rien n’est prêt pour la production non plus, ni réplication, ni sauvegarde, ni partitionnement d’une table qui grossit d’environ 75 000 lignes par jour. Et la latence de bout en bout restera bornée par la source, déjà vieille de 34,5 secondes en médiane quand je la lis.
Dans l’ordre, ce que je ferais ensuite : une alerte sur la fraîcheur plutôt qu’un test au prochain
dbt build, le partitionnement mensuel de la table de faits, puis l’ajout des vélos hors station
(free_bike_status), aujourd’hui ignorés.