Lire une émotion dans le décor : EMOTIC et contexte de scène
Projet de recherche en binôme : nous avons greffé sur un modèle CNN de référence un vecteur de 114 dimensions qui décrit la scène (objets YOLO, couleurs, luminosité), pour reconnaître 26 émotions sur EMOTIC. Il se termine par une boucle de génération d'images guidée par l'émotion.
- mAP B+I+Y, test EMOTIC (26 émotions)
- 25,60 %
- Gain de la branche 114D sur B+I
- +0,49 pp
- Référence Kosti et al. (B+I)
- 27,38 %
- Paires objet x émotion significatives, avant entraînement
- 654 / 2 080
Contexte et problème
Plus de 25 % des images prises en milieu naturel ont des visages masqués ou trop petits (Kosti et al., 2020). Un modèle qui ne regarde que le visage est alors démuni, alors qu’un humain lit aussi le décor : une table dressée, un gant de baseball qui traîne.
Avec Malala Ravalisaona, nous avons posé deux questions. La première est une question de performance : un vecteur explicite de 114 dimensions décrivant la scène améliore-t-il un modèle de référence qui combine un CNN sur la personne et un CNN sur l’image entière (B+I) ? La seconde porte sur l’interprétabilité : peut-on mesurer quels objets et quelles couleurs le modèle associe à quelles émotions ?
Nous l’avons présenté sous forme de poster. Le code est publié ; les chiffres de cette fiche viennent du poster, car les notebooks Colab n’ont conservé aucune sortie.
Données
EMOTIC (Kosti et al., IEEE TPAMI 2020) : 23 571 images en milieu non contrôlé, 34 320 personnes annotées. Chaque personne porte un cadre, une ou plusieurs des 26 catégories d’émotions et trois notes continues Valence, Arousal, Dominance (VAD) sur une échelle de 1 à 10.
Les annotations arrivent dans un fichier MATLAB, que nous convertissons en CSV par split, une ligne par personne. Le déséquilibre est fort : Engagement dépasse 12 000 annotations, Pain, Embarrassment et Suffering restent sous 500.
EMOTIC n’est accessible que sur demande, pour un usage de recherche non commercial. Nous ne le redistribuons donc pas dans le dépôt, qui documente la procédure d’accès.
Approche
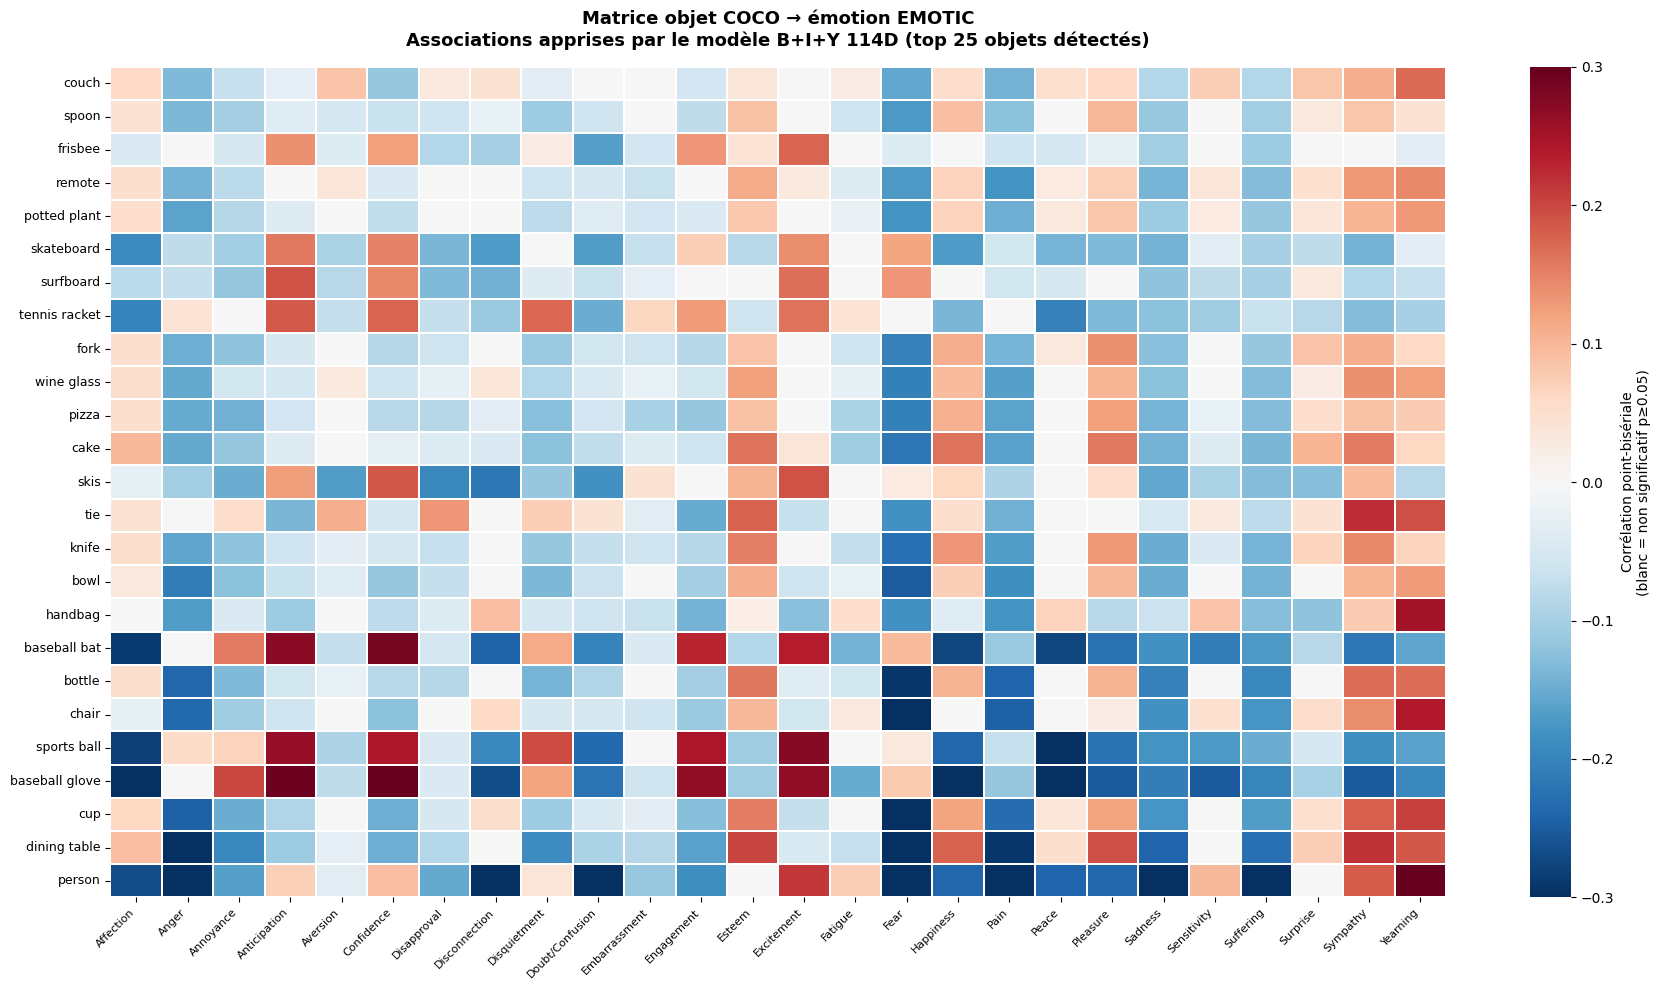
- Avant d’entraîner quoi que ce soit, une preuve de concept. YOLOv8-medium détecte les objets COCO de chaque image, et une corrélation point-bisériale entre présence d’objet et émotion annotée est calculée pour les 80 × 26 paires.
- Le vecteur de scène fait 114 dimensions : 80 scores YOLO (confiance maximale par classe), 5 couleurs dominantes par K-means (15), un histogramme HSV (16) et luminosité, contraste, saturation (3).
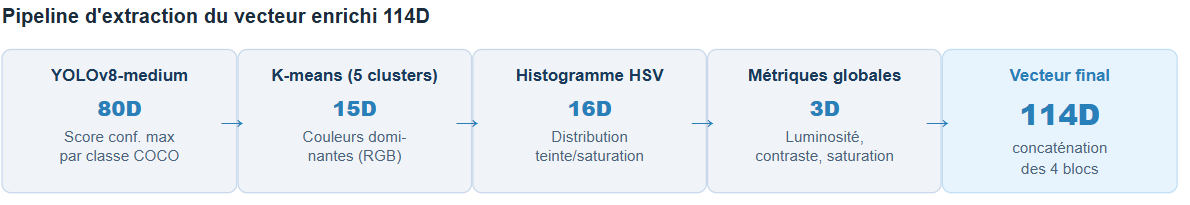
- Deux modèles, entraînés dans les mêmes conditions. B+I associe un EfficientNet-B2 sur la personne recadrée et un ResNet-50 sur l’image entière, fusionnés par une tête commune qui sort 26 logits et 3 valeurs VAD. B+I+Y ajoute la branche 114D, un petit MLP (30 832 paramètres) avec une attention softmax sur les objets et une sur les couleurs. Entraînement en deux phases : 5 époques backbones gelés, puis 20 de réglage fin.
- Pour l’interprétabilité : corrélation entre objets détectés et probabilités prédites sur le test, poids d’attention, profil photométrique de chaque émotion.
- La génération guidée est restée en perspective. Pour 6 émotions cibles, une image est produite par transfert de style photométrique ou par Stable Diffusion v1.5 (prompt construit à partir de la matrice objet × émotion), puis reclassée par B+I+Y pour vérifier sa cohérence.
Pour la publication, nous avons nettoyé les six notebooks (chemins Drive regroupés dans une configuration, cellules de débogage retirées) et isolé les architectures dans un module Python. Un test de fumée instancie les deux modèles sur CPU, sans données ni poids pré-entraînés, vérifie les sorties (26 et 3) et contrôle que chaque notebook définit exactement les mêmes couches que le module.
Choix techniques
| Choix | Plutôt que | Pourquoi |
|---|---|---|
| Vecteur de scène explicite (YOLO, K-means, HSV) | Un troisième CNN de contexte | Chaque dimension a un sens, un objet ou une couleur : on peut regarder ce que le modèle en fait |
| Preuve de concept statistique avant l’entraînement | Ajouter la branche YOLO à l’aveugle | 654 paires sur 2 080 sont significatives (31,4 %, contre environ 5 % attendus par hasard), de quoi tenter la branche |
| Focal Loss (γ = 2) et échantillonnage pondéré | Entropie croisée binaire simple | Compenser le déséquilibre entre Engagement et les classes rares |
| Préchauffage à backbones gelés, puis taux d’apprentissage séparés (1e-4 tête, 1e-5 backbones) | Réglage fin de tout le réseau dès la première époque | Éviter d’abîmer les poids ImageNet pendant que la tête, initialisée au hasard, apprend |
| Même backbone et même protocole pour B+I et B+I+Y | Comparer au seul chiffre du papier | Isoler l’effet de la branche 114D (ablation) |
| Perte VAD masquée | Remplacer les VAD manquantes par une valeur | Ne pas apprendre sur des cibles absentes |
Résultats et métriques
Sur le test set EMOTIC (7 280 images selon le poster) :
| Modèle | mAP | MAE valence | MAE arousal | Pearson valence |
|---|---|---|---|---|
| Kosti et al., B+I (papier) | 27,38 % | 0,0528 | 0,0611 | |
| B+I, notre référence | 25,11 % | 0,0968 | 0,1043 | 0,225 |
| B+I+Y 114D | 25,60 % | 0,0980 | 0,1060 | 0,248 |
La branche de scène apporte +0,49 point de mAP, soit +1,9 % relatif. Le gain est réel mais petit, et notre modèle reste 1,8 point sous le papier original. Il est aussi inégal selon les émotions : Suffering, Sadness et Fatigue progressent le plus, Annoyance, Affection et Peace reculent.
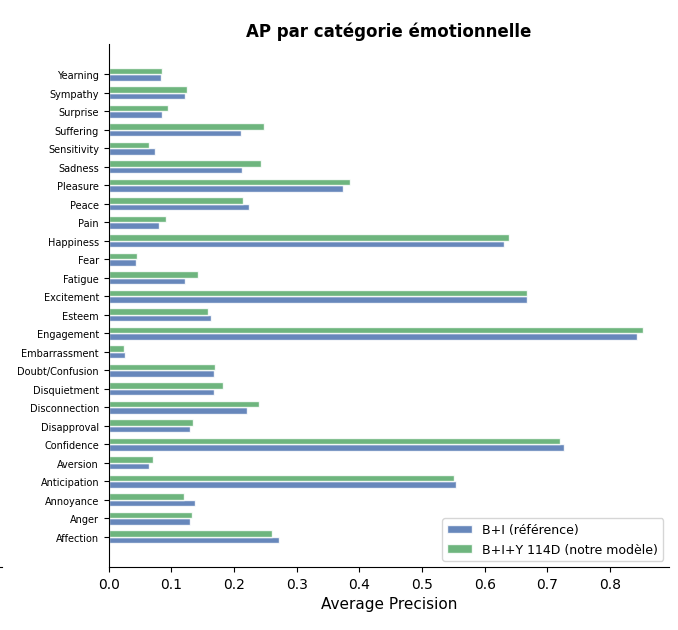
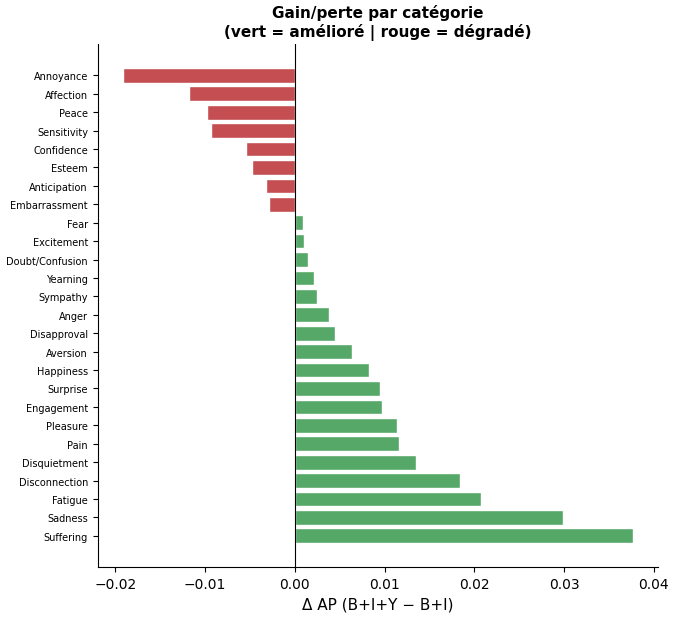
En VAD, la corrélation en valence s’améliore (0,248 contre 0,225), mais pas l’erreur absolue. La dominance reste la plus difficile (Pearson r = 0,31).
Du côté de l’interprétabilité, 1 235 paires objet × émotion sur 2 080 (59,4 %) sont significatives dans les prédictions du modèle, avec une corrélation maximale de 0,49. Quelques exemples : person et Yearning (+0,38), baseball glove et Confidence (+0,31), baseball glove et Affection (−0,32).
Impact métier
Travail d’études à deux, présenté sous forme de poster : rien n’a été déployé, et je ne revendique aucun gain en entreprise. Ce que le projet apporte, c’est une réponse chiffrée à une question de conception que se pose une équipe de recherche en vision par ordinateur : décrire la scène par des variables explicites (objets, couleurs, lumière) qui se relisent, ou ajouter un troisième réseau qu’on ne saura pas interroger ?
- Mesuré : avant tout entraînement, 654 paires objet × émotion sur 2 080 sont statistiquement liées,
soit 31,4 % contre environ 5 % attendus par hasard (
results/resultats_poster.json). La piste valait donc le temps de calcul qu’elle allait coûter. - Mesuré : la branche ajoutée pèse 30 832 paramètres sur les 33,2 millions du modèle, moins de 0,1 %
de sa taille, pour +0,49 point de reconnaissance (
results/parametres_mesures.json, recompté dans le code). Le gain est modeste, le coût aussi, et les deux chiffres sortent du code. - Estimé, au conditionnel : pour une équipe qui doit expliquer une prédiction à un comité d’éthique ou à un commanditaire, la lisibilité d’un descripteur explicite compterait sans doute davantage que ce demi-point. C’est une hypothèse de travail issue de l’usage courant en recherche, pas un résultat mesuré.
Limites et pistes d’amélioration
- Résultats non réexécutés : les chiffres viennent du poster, sans checkpoint ni journal d’entraînement conservé. Une seule exécution, sans intervalle de confiance : +0,49 point peut relever de la variance.
- Vecteur YOLO creux : 24 % des images n’ont aucun objet détecté à confiance supérieure à 0,25, et l’attention apprend des poids presque uniformes (environ 1/80). Une représentation dense et spatiale serait plus informative.
- Schéma du poster simplifié : en recomptant les paramètres dans le code, la tête de fusion en a 1,94 million, pas 1,16 million, et ResNet-50 utilise des poids ImageNet, pas Places365. Le dépôt détaille ces écarts.
- Génération : nous avons recopié les profils photométriques à la main depuis un graphique, et le poster ne chiffre pas le taux de réussite. Une preuve de faisabilité, donc, sans résultat à annoncer.
- Suite : plusieurs graines, backbone de contexte pré-entraîné sur Places365 comme dans le papier, et scores d’objets continus pondérés par la surface.